|
【重庆GEO运营公司】AI幻觉与企业错误引用,根源来自哪些全网信息问题上期文章: 【重庆GEO运营公司】GEO低质信源有哪些危害?如何识别马甲站灌水内容
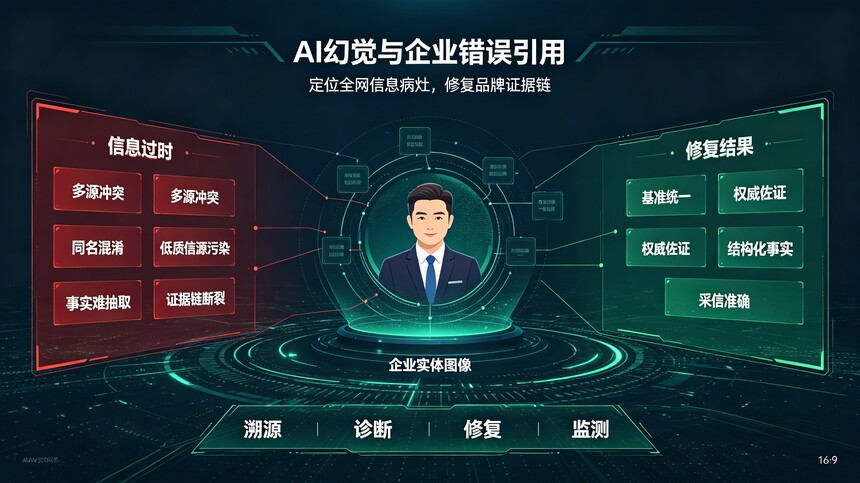
Meta摘要:很多B2B企业遇到AI错误引用、幻觉问题,第一反应是大模型本身不稳定。但在RAG检索生成的机制下,绝大多数指向企业的错误回答,根源不在模型,而在于全网公开信息环境的缺陷:信息过时、多源口径冲突、实体识别歧义、低质信源污染、事实结构化缺失、信息孤岛。本文拆解六大类全网信息问题,解释它们如何诱发AI幻觉、造成企业信息被错引,配套GEO治理思路,帮助企业从源头降低AI错误引用概率,稳定品牌在AI问答场景的可信度。 在生成式搜索场景,B端采购者通过AI问答查找供应商、产品参数、资质、交付案例时,经常出现AI输出和企业真实情况不符的内容:参数写错、资质张冠李戴、业务范围描述错误、引用已经下线的产品、甚至把别家企业的案例、处罚信息归到自家品牌上。 不少企业将这类现象简单归为“AI不靠谱、会编造内容”。但面向全网检索的RAG模式,大模型是先从互联网召回多条公开信源,再交叉比对、整合输出答案。AI幻觉与企业错误引用,大多是全网原始信息本身存在缺陷,模型只是放大了这些信息矛盾。GEO治理的核心,就是定位并修复这些全网信息层面的病灶。 一、过期遗留信息沉淀,新旧版本并行存在这是B2B企业最高发的诱因。企业发生更名、搬迁、产品线迭代、资质到期、服务范围调整之后,只更新官网,忽略全网大量历史信源。 行业媒体稿件、B2B平台档案、黄页、历史供需信息、第三方资料库不会自动同步更新,旧信息会长期留在索引库中,持续被检索召回。 当新旧两套信息同时被召回,模型缺少权威的时间戳、变更说明作为判断依据,很可能优先采信存量更大的旧数据,形成“官网已经改了,AI还在说旧信息”的幻觉现象。
二、全网信源口径不统一,事实互相冲突企业内部多部门、多渠道各自对外发布信息,没有统一事实基准库,同一事实在不同平台出现多个版本。 同样一款设备的交付周期、质保年限、产能参数、资质编号,官网、电商店铺、销售软文、行业平台入库资料描述各不相同。 大模型交叉核验时,会发现多条来源说法不一致,无法判定哪一个是权威版本。此时模型有两种倾向:要么折中拼接一套混合内容,形成幻觉;要么降低整个品牌实体的可信度评分,减少推荐。 三、实体歧义、同名混淆,造成信息张冠李戴B2B行业大量存在同名、近似名称的企业、产品、项目。 全网信息缺少清晰的实体标识、主体绑定信息,大模型在做实体链接时容易混淆:把同行业另一家公司的案例、证书、负面信息,错误关联到你的企业名下;或者把母公司、子公司、不同产品线的资质随意混用。 这类幻觉的隐蔽性很强,很多企业排查很久,才发现错误源头来自同名主体的信息混淆,而不是自家内容写错。 四、低质马甲站、灌水内容污染信源池批量站群、马甲软文、AI洗稿灌水内容,是GEO场景下重要的信息污染源。 服务商批量在大量无备案、无真实运营主体的站点发布同质化内容,内容里参数夸大、事实虚构、随意编造资质和案例。当虚假内容在全网形成一定数量的同源稿件,RAG检索会批量召回这些噪声。 模型会被“多条来源都说一样的话”误导,把虚假描述当成可信事实输出。这类污染一旦形成,清理周期很长,也是很多企业越铺稿、AI回答越混乱的原因。 五、信息非结构化,缺少可核验事实锚点很多企业对外内容以营销软文为主,文字偏向描述、宣传,缺少结构化、可独立核验的事实单元。 没有明确的参数条目、证书编号、项目时间、验收标准、生效时间;事实混在大段营销话术里面,大模型很难精准抽取事实,容易自行脑补、推演补充信息,产生编造式幻觉。 同样一条事实,带有明确时间戳、编号、结构化标注的页面,比长篇抒情软文更容易被模型准确识别,减少自由发挥。 六、信息孤岛、证据链断裂,缺少权威佐证企业核心事实只放在自有官网,没有在公信平台、行业协会、权威垂直媒体同步配套佐证信源,形成单一信源孤岛。 当只有官网一个来源,缺少第三方独立背书,一旦官网页面抓取不稳定、页面改版、链接失效,大模型检索时就会失去可靠证据,转而抓取其他零散、低质量的网络碎片信息进行补全,进而出现错误引用。 可信GEO的证据链,需要自有权威阵地+公信公示渠道+垂直行业平台多方对齐,而不是单一官网承载全部事实。 从源头治理:对应的GEO优化方向
FAQQ1:AI幻觉到底是模型问题,还是网上信息问题?A:两者都有可能。面向网页实时检索的RAG模式,绝大多数企业信息类错误引用,根源是全网公开信息冲突、过时、污染;模型原生幻觉更多是无依据编造冷门知识。B2B供应商、产品参数类错误,优先排查全网信源。 Q2:如果我把所有旧信息都删掉,是不是就不会被AI引用旧内容?A:不一定。很多第三方平台、历史索引缓存不会随你的删除操作同步清理。盲目删稿还会丢失实体历史上下文,推荐做法:保留旧内容并标注历史版本,同步发布权威更新公告,给模型清晰的时序判断依据。 Q3:怎么区分AI错误是同名混淆,还是自家口径不一致?A:做溯源测试:复制AI错误回答里的关键词,检索对应的原始网页,看错误信息的来源主体。如果来源企业主体和你不是同一家,属于同名实体混淆;来源是你自己的各个渠道,就是口径冲突。 Q4:已经有很多马甲虚假内容在网上,怎么降低它对AI引用的影响?A:优先持续产出权威、结构化、可核验的基准内容,搭建高可信度信源矩阵,用高质量证据拉高品牌整体可信度权重;停止继续新增低质稿件,定期监测相关问句,观察噪声内容采信占比逐步下降。 Q5:官网内容写得很准确,为什么AI还是会拼接错误信息?A:RAG会同时召回多条网页,不只是官网。哪怕官网内容正确,只要大量冲突、过时、低质信源同时被召回,模型在整合多条信息时,依然可能出现拼接错误。GEO需要治理全网,而不是只优化官网。 Q6:有没有办法完全杜绝AI幻觉和错误引用?A:无法做到100%杜绝。大模型的检索、语义理解机制本身存在不确定性。企业目标是持续降低幻觉概率,把品牌核心事实的权威证据链做扎实,让AI优先采信准确版本,减少错误信息输出。 Q7:GEO监测的时候,重点要监测哪些容易引发幻觉的信息维度?A:核心事实维度:企业主体名称、地址、联系方式、资质证书、产品参数、交付能力、项目案例、业务范围。这些属于实体硬事实,一旦冲突,最容易触发AI错误引用。 |